上市公司
Securities industryAI产业价值迁移五讲 · 第1讲
AI浪潮不是软件突然摆脱硬件而独立发生的奇迹。它建立在晶体管、集成电路、微处理器、存储器、GPU、先进制程、封装和高速互连数十年的累积之上。理解这条历史,才能理解为什么每一轮算力革命都会制造新的产业瓶颈,也能避免把今天的GPU龙头简单等同于未来全部价值。
1947年,贝尔实验室的约翰·巴丁和沃尔特·布拉顿制成点接触晶体管。它比真空管更小、更可靠、功耗更低,也不需要漫长预热。这个看似简单的三端器件,让电子信号可以被放大和开关,现代计算最基本的“0”和“1”由此获得了可大规模复制的物理载体。
1958年至1959年,杰克·基尔比和罗伯特·诺伊斯分别推动集成电路诞生。此前,晶体管、电阻、电容需要一个个焊接;集成电路把多个器件制作在同一块半导体材料上。计算能力第一次不再主要依靠组装更多独立元件,而是依靠在更小面积里集成更多功能。
这一步改变了整个产业的经济学。单个晶体管不断缩小,单位计算成本持续下降,可靠性反而提高。所谓摩尔定律,重要的从来不只是“晶体管数量定期翻倍”,而是它长期形成了一套产业预期:设计公司敢开发更复杂的软件,设备公司敢投入下一代制造工具,晶圆厂敢建设更昂贵的产线,因为所有人都相信下一代芯片会处理更多任务。
1971年,英特尔推出4004。它最初来自日本计算器公司的定制项目,却最终成为首款商业化通用微处理器之一。过去,要改变电子设备的功能,往往需要重新设计硬件;微处理器把计算逻辑集中到可编程芯片中,同一块硬件可以通过不同软件执行不同任务。
1970年代,MOS晶体管开始在DRAM和微处理器中大量应用;到1980年代,MOS成为数字芯片的主流基础。CPU、DRAM和操作系统共同推动个人电脑普及。此后的二十多年,产业主线十分清晰:CPU提高通用计算性能,存储器提供更大容量,软件把越来越多现实任务翻译成指令。
在这个阶段,价值主要围绕“通用计算”展开。英特尔与微软的组合成为典型:前者提供处理器架构和制造能力,后者提供操作系统与应用生态。硬件升级推动软件扩张,软件需求又反过来推动用户更新硬件。
但通用CPU擅长复杂控制,并不适合以最高效率执行海量、结构相似的并行计算。图形渲染恰好需要同时处理大量像素和顶点,GPU因此走上另一条路线:牺牲部分通用性,换取更强的并行吞吐。
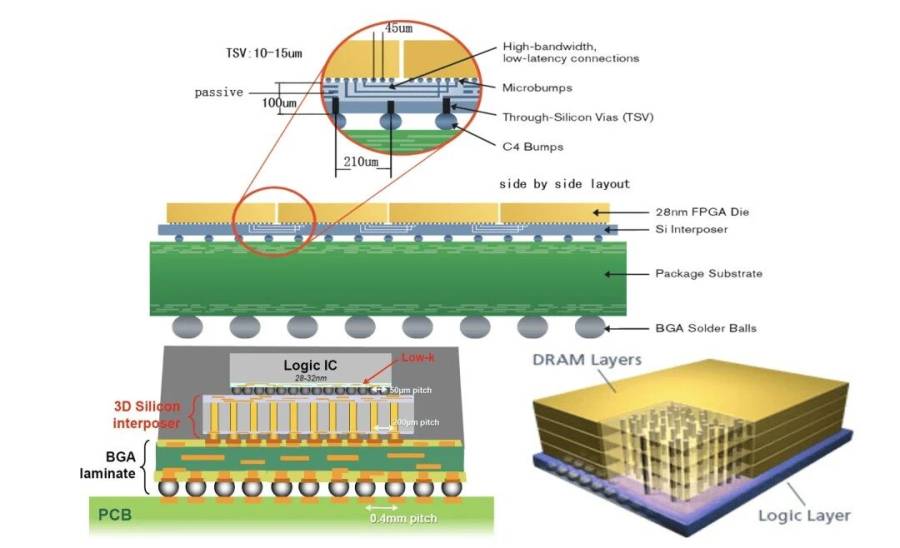
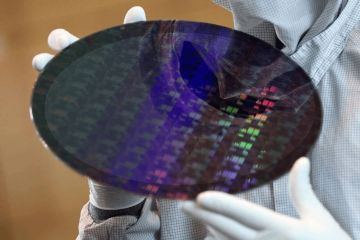
早期半导体公司往往同时负责设计、制造、封装和销售,这种模式后来被称为IDM。随着制程越来越复杂,一座先进晶圆厂需要投入数百亿美元,单个设计团队很难同时承担产品创新与制造投资。
1987年成立的台积电推动专业晶圆代工模式成熟:晶圆厂不与客户竞争终端芯片,专门负责制造;Fabless公司可以把资源集中在架构、产品和软件;EDA公司提供设计与验证工具;Arm等IP公司把处理器和接口模块授权给不同客户;封装测试公司承接后段工序。
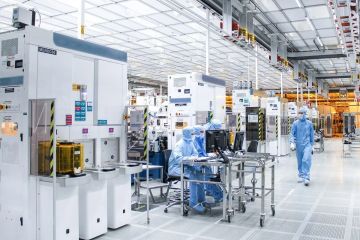
专业分工降低了芯片创业的固定资产门槛,也让每个环节形成更深的技术积累。智能手机时代的SoC、通信芯片和GPU快速迭代,都受益于这套全球协作网络。与此同时,产业链也变得更集中:先进逻辑依赖少数晶圆厂,EUV依赖阿斯麦,EDA、关键材料和封装各有难以替代的供应商。效率提高与供应链脆弱性是同一套分工模式的两面。
AI进一步放大这种关系。加速器设计公司需要晶圆厂、HBM供应商和封装产能共同配合,云客户又必须提前给出需求计划。今天一款AI芯片能否按时上市,取决于跨公司协同,而不只是芯片设计是否完成。
英伟达在1999年推出GPU概念,最初服务于3D游戏与图形。2006年推出CUDA后,开发者可以使用更通用的编程方式调用GPU,而不必把计算任务伪装成图形指令。GPU由专用图形设备逐步变成可编程并行计算平台。
CUDA的真正价值不只是让一块芯片跑得更快,而是把硬件、编译器、数学库、开发工具和工程师习惯连接成生态。竞争者即使设计出计算性能接近的芯片,也仍要面对软件迁移、开发工具、模型优化和已有代码库形成的转换成本。
2012年的AlexNet成为关键转折。研究团队使用两块英伟达 GTX 580 GPU训练深度卷积神经网络,在ImageNet图像识别中取得突破。数据、算法和GPU算力在这一刻形成闭环:互联网提供大规模数据,神经网络找到可扩展的学习方法,GPU让训练时间进入现实可接受范围。
2017年,《Attention Is All You Need》提出Transformer架构。与需要按顺序处理信息的传统循环网络相比,Transformer更适合并行计算。算法结构与GPU的吞吐优势互相匹配,模型规模、数据规模和计算规模开始共同扩张。
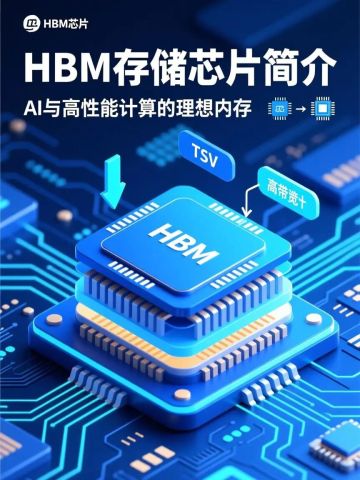
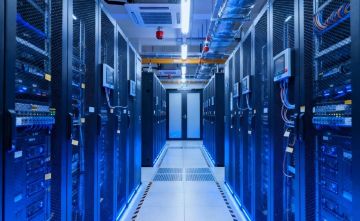
2022年11月,ChatGPT向公众开放。大模型第一次以低门槛对话产品进入大众市场,但产品背后并不是一台“会思考的电脑”,而是一整套数据中心系统:GPU或专用加速器负责矩阵计算,HBM不断喂入参数和中间数据,高速网络连接数千乃至更多芯片,CPU和内存承担调度,存储系统保存训练数据,电力和散热系统维持持续运行。
传统个人电脑时代,用户关心CPU主频、内存容量和硬盘大小。AI时代,单颗芯片的峰值算力仍然重要,但系统能否持续交付有效算力,取决于多个环节同时工作。
第一,模型参数和上下文不断增加,计算单元等待数据的时间可能比计算本身更昂贵。HBM的带宽、容量和良率因此成为核心约束。
第二,单颗芯片无法独立完成超大模型训练。GPU之间、服务器之间必须高速交换数据,网络交换芯片、光模块、铜互连和光互连的重要性随集群规模上升。
第三,先进制程只能解决部分问题。为了把计算芯片、HBM和不同功能芯粒连接起来,CoWoS、SoIC等先进封装逐渐成为系统性能的一部分。封装从芯片制造完成后的“外壳”,变成共同决定带宽、功耗和良率的关键工艺。
第四,算力最终受电力约束。AI服务器功率密度提升后,供电、液冷、备用电源和数据中心选址都会影响芯片能否真正上线。买到GPU不等于形成可出售的Token,能够稳定运行、被软件调度并获得付费需求,才形成经济回报。
所以,AI半导体的竞争单位正在由一颗芯片变成一个计算系统,再由计算系统扩展到整个数据中心。芯片设计仍然是价值最高的环节之一,但内存、封装、网络和能源会在不同阶段轮流成为最稀缺的瓶颈。
如果只按发明排序,容易把产业史写成一串技术名词。换成公司发展阶段,可以看到每一代龙头都先解决一个关键瓶颈,再把优势扩展成平台。
| 公司 | 第一阶段 | 第二阶段 | 第三阶段 | 未来竞争焦点 |
|---|---|---|---|---|
| 英特尔 | 1970年代以DRAM和4004微处理器进入通用计算 | x86与PC生态使处理器成为个人电脑的标准部件 | 制程领先受挫后重建制造体系,同时进入独立晶圆代工、AI加速与先进封装 | 能否按期推进先进节点并取得外部代工客户;若利用率不足,巨额折旧会继续压低回报 |
| 台积电 | 1987年建立专业晶圆代工,不与客户竞争芯片产品 | 智能手机时代依靠先进制程与大客户进入规模领先 | AI时代把领先制程、CoWoS、SoIC和全球产能组合成系统制造能力 | 2纳米及后续节点良率、先进封装扩产、海外厂成本与地缘分散之间的平衡 |
| 阿斯麦 | 1984年从光刻设备创业,1990年代靠PAS 5500站稳市场 | 2000年代以TWINSCAN和浸没式光刻提高精度与产能 | 2010年代推动EUV量产,2023年交付首套High-NA EUV,并进入先进封装光刻 | High-NA能否按客户节奏提升生产率,同时管理供应商、出口限制和客户资本开支风险 |
| 英伟达 | 1990年代从3D游戏图形起步,1999年提出GPU概念 | 2006年CUDA把图形芯片变成可编程并行计算平台 | 由AI加速器扩展到CPU、NVLink、网络、整机与软件服务 | 系统效率与CUDA生态能否抵消云厂商定制ASIC的成本优势,并维持平台毛利率 |
| 美光 | 从1978年小型DRAM团队成长为成本竞争者 | 通过并购和与英特尔合资进入NAND,形成DRAM、NAND和NOR组合 | 数据中心与HBM把竞争从容量、价格推进到带宽、功耗、堆叠与长期认证 | HBM4/4E良率、客户份额和长期合同能否降低传统存储周期的利润波动 |
这五条路线说明,领先地位很少只来自一次产品成功。英特尔与英伟达证明架构需要软件生态,台积电与阿斯麦证明工艺需要数十年设备和客户协同,美光则说明产品升级若不能改变供给纪律,利润仍会回到周期。未来的赢家要同时完成技术升级、规模制造和商业模式升级。
第一,硬件与软件从来不是彼此替代。4004需要软件才能成为通用处理器,GPU需要CUDA才能成为计算平台,大模型也需要云、工具调用和应用入口才能形成收入。只研究晶体管数量而忽略软件生态,会低估平台壁垒;只研究用户增长而忽略硬件成本,也会高估商业化速度。
第二,每一次性能跃升都会把瓶颈推向下一个环节。CPU更快后,内存和硬盘变慢;GPU更快后,HBM、先进封装和互连成为约束;集群继续扩大后,电力、冷却和推理成本又会限制部署。产业链机会常常出现在“原来不起眼、现在卡住全系统”的位置。
第三,技术需求具有结构性,利润却仍有周期。存储器、设备和晶圆制造需要提前投入巨额资本。当供给不足时,价格和利润会急升;企业集体扩产后,供需可能再次反转。AI可以抬高长期需求中枢,却不会自动消灭半导体周期。
第四,最终价值取决于有效使用,而不是采购数量。云厂商资本开支、芯片出货和数据中心开工是领先指标;推理调用、客户续费、单位Token成本和自由现金流,才决定AI基础设施能否形成长期回报。
从晶体管到生成式AI,产业并不是沿一条直线前进,而是在计算、存储、互连、制造和软件之间反复寻找新的平衡。下一篇将把这套系统完整拆开:从EDA、设备、材料和晶圆厂,一直走到HBM、先进封装、光通信、电力与智能体应用,判断2026年AI半导体产业链的利润究竟流向哪里。
本讲引用的公开资料如下,数据与事实均来自公司公告、监管文件或官方机构发布。
诺贝尔奖教育资料:晶体管与集成电路历史
英特尔:4004微处理器历史
IEEE固态电路学会:集成电路与MOS历史
台积电公司历史与专业晶圆代工模式
阿斯麦公司发展史:从步进式光刻到High-NA EUV
英伟达公司技术时间线
英伟达 CUDA编程指南
AlexNet论文资料
Transformer原始论文
OpenAI:ChatGPT于2022年11月发布
台积电2025年年报:3DFabric、CoWoS与AI制造
美光公司发展时间线
这是《AI产业价值迁移五讲》第1讲。下一讲,我们把2026年的AI工厂拆开,看利润到底留在哪一环。
这个系列会持续更新,把AI时代的产业逻辑一层层拆给你看。关注「用心小站」,不错过下一讲。
想聊聊半导体和AI产业链的机会和风险?加微信 yxxz798,说说你的看法。
关注用心小站,获取更多深度分析
风险提示:本文用于产业研究与投资教育,所引数据来自公司公告与公开资料,市值与利润随市场变化,不构成证券买卖建议。股市有风险,入市需谨慎。
扫码添加企业微信 · 加入读者交流群
每天一篇深度财经文章 · 了解基金、量化基金选择,欢迎入群交流
扫码添加企业微信
添加微信扫码
(添加企业微信后自动发送入群链接)
评论专区
Comment area推荐产品
product新闻资讯
information
Securities industry
Bank financial management
Trust financing
微信公众号
 官方微信
 产品小程序